четверг, 21 мая 2009 г.

Опять игры с сегментами

При попытках понять как работают компиляторы, отладчики и прочая сказочная живность начинаешь обнаруживать интересные вещи. И становится не понятно, то ли это ошибки компиляторов и отладчиков, то ли это их фишки :)
Итак ближе к монитору. Новая серия "Hello World". Нас ждут невероятные приключения в дебрях кода супер программы.

Итак нового мутанта в студию:

Казалось бы, что тут особенного?! В принципе так оно и есть, но вот TASM и MASM по разному компилируют данную программу, но это в принципе не самая интересная особенность. Интересно, то, что компилятор TASM инициализирует не правильным значением регистр SP (указатель стека). Происходит это видимо потому, что мы указали тип выравнивания для стека DWORD, что привело к тому, что стек начинается не на границе параграфа. Соответственно часть стека потерялась, то есть она ни когда не будет использована. Похоже что это глюк TASM. Смотрим следующий скриншот, и погружаемся в глубокую медитацию.

Замечаем, что отладчик использует стек отлаживаемой программы для своих целей. Это может ему дорого стать :) если со стеком что-нибудь сотворить. Но об этом в следующей серии нашего сериала.
Выпуск серий чуть опаздывает от моего изучения ассемблера и исследования поведения компиляторов и отладчиков.
И так, на что следует обратить внимание на скриншоте. Во первых, TASM абсолютно правильно, скомпилил EXE файл, в соответствии с теми атрибутами выравнивания сегментов что мы задавали, НО вот при загрузке в память программы регистр SP получил не правильное значение, и указывает не на дно стека (вернее не на перове слово за концом стека), а указывает на начало параграфа, считая что стек начинается на границе парагарфа, но у нас он не начинается на границе параграфа! Вот такой вот глюк, ну или фишка :). Второе это, то, что отладчик помещает на дно стека два нулевых байта в начале своей работы. Зачем он это делает? Не знаю... Видимо ему это нужно :)
Из всего этого вывод, что работу компиляторов надо проверять :) Не факт, что они создадут, то что мы задумывали :)
Теперь посмотрим как MASM откомпилил нашу прогу:

MASM просто забил на наш атрибут DWORD для выравнивания стека. Он все равно расположил его, как видим, на границе параграфа. В принципе и правильно сделал :) видимо не захотел мучится с высчитыванием смещения дна стека :)
Смотрим все под отладчиком:

Видим, что сейчас с SP все в порядке.

Теперь повторим наш эксперимент с установкой значений SS и SP вручную. Изучаем внимательно текст программы:

И смотрим какой EXE создал TASM:

Стоит обратить внимание даже на визуальное представление стека. Далее как водится загоняем прогу в отладчик. Далее приведен скриншот еще до выполнения первой команды.

Как видим, наш стек девственно чист, и не осквернен отладчиком :), так как он полагает что стек находится в другом месте :), в конце PSP. Теперь выполним все команды до mov ax,13D5, т.е. команды которые заносят в регистры SS и SP правильные значения.

Теперь, как видно, все в порядке, но в стеке много "мусора", который занес туда отладчик.
MASM тоже отранслировал эту программу. Размер совпал с размером проги отранслированной TASM.

среда, 20 мая 2009 г.

Игры с сегментами

Итак сериал "Hello World" продолжается. Серия уже не помню какая :), но нам же по барабану! :) Мы же фанаты супер гига мега проги всех времен и народов - "Helo World". Итак к монитору! :) Будем воплощать теорию в практику!

Начнем с классики, т.е. со стандартных директив сегментации. И так програ:

Ассемблируем ее:

И получили предупреждение, что стек не определен. И правильно. Вспоминаем описание атрибутов комбинирования сегментов. В частности атрибут stack.

Смотрим расположение сегментов в исполняемом файле:

Все как мы описывали. То есть сегменты располагаются так как мы их описали.

И смотрим расположение сегментов в памяти:

Тут тоже все на своих (нами определенных) местах.
Программа, будет исполнятся, не смотря на отсутствие определения стека. Так как в этой программе мы стек не используем, а вносим его определение для примера и наглядности.

Теперь немного поменяем программу вот таким образом:

Транслируем:

Внимательно смотрим листинг:

Смотрим содержимое EXE файлика:

Убеждаемся, что сегменты расположены в порядке, который мы определили в программе. А так же, что сегменты выравнены как мы и указали. Внимательно медитируем на все это, вспоминаем, что было написано про выравнивание и умнеем прямо на глазах :)

Теперь, святое дело, загоняем программу в отладчик:

Скриншот сделан еще до выполнения первой команды программы. Замечаем, что SS установлен на конец PSP, вернее на первое слово за ним, т.е. на начало программы (не путать с точкой входа в программу). Регистр SP вообще не инициализирован. Так же видим, что сегменты располагаются в памяти, в том порядке, как мы их и описали в программе.
Внимательно анализируем значения регистров, углубленно медитируем и просветляемся.
Затем гоняем прогу под отладчиком и становимся еще умнее :)

вторник, 19 мая 2009 г.

Синтаксис ассемблера. Директива ASSUME

Все сегменты сами по себе равноправны, так как директивы SEGMENT и ENDS не содержат информации о функциональном назначении сегментов. Для того чтобы использовать их как сегменты кода, данных или стека, необходимо предварительно сообщить транслятору об этом, для чего используют специальную директиву ASSUME, имеющую формат, показанный на рисунке ниже. Эта директива сообщает транслятору о том, какой сегмент к какому сегментному регистру привязан. В свою очередь, это позволит транслятору корректно связывать символические имена, определенные в сегментах. Привязка сегментов к сегментным регистрам осуществляется с помощью операндов этой директивы, в которых имя_сегмента должно быть именем сегмента, определенным в исходном тексте программы директивой SEGMENT или ключевым словом nothing. Если в качестве операнда используется только ключевое слово nothing, то предшествующие назначения сегментных регистров аннулируются, причем сразу для всех шести сегментных регистров. Но ключевое слово nothing можно использовать вместо аргумента имя сегмента; в этом случае будет выборочно разрываться связь между сегментом с именем имя сегмента и соответствующим сегментным регистром.

Внимание, на рисунке указаны сегментные регистры, которые появились в старших процессорах (после 8086).

понедельник, 18 мая 2009 г.

Синтаксис ассемблера. Директива SEGMENT

Директивы

Ассемблер имеет ряд операторов, которые позволяют управлять процессом ассемблирования и формирования листинга. Эти операторы называются псевдокомандами или директивами. Они действуют только в процессе ассемблирования программы и не генерируют машинных кодов. Директивы формирования листинга не очень интересны, так как вывести на печать текст программы не составляет труда для любого современного редактора.
Директивы ассемблирования буду изучать и по ходу дела добавлять их в блог. К сожалению, стройного и полного описания директив ассемблирования и примеров, разъясняющих их назначение и разницу между их параметрами, нет ни в одной из имеющихся у меня книг. Более-менее они описаны опять же у старичка Абеля (но книжка все таки старовата) и не плохое есть описание есть у Юрова, но что тот, что другой не приводят ни каких примеров, которые бы пояснили разницу между параметрами директивы SEGMENT и т.д. Так что придется все исследовать самостоятельно.

Директива SEGMENT

Любые ассемблерные программы содержат, по крайней мере, один сегмент - сегмент кода. В некоторых программах используется сегмент для стековой памяти и сегмент данных для определения данных.
Еще раз вспомним, что физически сегмент представляет собой область памяти, занятую командами и (или) данными, адреса которых вычисляются относительно значения в соответствующем сегментном регистре.

Стандартные Директивы Сегментации

Синтаксическое описание сегмента на ассемблере представляет собой конструкцию, изображенную на рисунке ниже:

Важно отметить, что функциональное назначение сегмента несколько шире, чем простое разбиение программы на блоки кода, данных и стека. Сегментация является частью более общего механизма, связанного с концепцией модульного программирования. Она предполагает унификацию оформления объектных модулей, создаваемых компилятором, в том числе с разных языков программирования. Это позволяет объединять программы, написанные на разных языках. Именно для реализации различных вариантов такого объединения и предназначены операнды в директиве SEGMENT.
Рассмотрим их подробнее.

  • Атрибут выравнивания сегмента (тип выравнивания) сообщает компоновщику о том, что нужно обеспечить размещение начала сегмента на заданной границе. Это важно, поскольку при правильном выравнивании доступ к данным в процессорах i80х86 выполняется быстрее. Допустимые значения этого атрибута следующие:
    • BYTE — выравнивание не выполняется. Сегмент может начинаться с любого адреса памяти;
    • WORD — сегмент начинается по адресу, кратному двум, то есть последний (младший) значащий бит физического адреса равен 0 (выравнивание на границу слова);
    • DWORD — сегмент начинается по адресу, кратному четырем, то есть два последних (младших) значащих бита равны 0 (выравнивание на границу двойного слова);
    • PARA — сегмент начинается по адресу, кратному 16, то есть последняя шестнадцатеричная цифра адреса должна быть 0h (выравнивание на границу параграфа);
    • PAGE — сегмент начинается по адресу, кратному 256, то есть две последние шестнадцатеричные цифры должны быть 00h (выравнивание на границу 256-байтной страницы);
    • MEMPAGE — сегмент начинается по адресу, кратному 4 Кбайт, то есть три последние шестнадцатеричные цифры должны быть 000h (адрес следующей 4-Кбайтной страницы памяти).
    • По умолчанию тип выравнивания имеет значение PARA.


  • Атрибут комбинирования сегментов (комбинаторный тип) сообщает компоновщику, как нужно комбинировать сегменты различных модулей, имеющие одно и то же имя. Значениями атрибута комбинирования сегмента могут быть:
    • PRIVATE — сегмент не будет объединяться с другими сегментами с тем же именем вне данного модуля;
    • PUBLIC — заставляет компоновщик соединить все сегменты с одинаковыми именами. Новый объединенный сегмент будет целым и непрерывным. Все адреса (смещения) объектов, а это могут быть, в зависимости от типа сегмента, команды и данные, будут вычисляться относительно начала этого нового сегмента;
    • COMMON — располагает все сегменты с одним и тем же именем по одному адресу. Все сегменты с данным именем будут перекрываться и совместно использовать память. Размер полученного в результате сегмента будет равен размеру самого большого сегмента;
    • AT xxxx — располагает сегмент по абсолютному адресу параграфа (параграф — объем памяти, кратный 16; поэтому последняя шестнадцатеричная цифра адреса параграфа равна 0). Абсолютный адрес параграфа задается выражением xxx. Компоновщик располагает сегмент по заданному адресу памяти (это можно использовать, например, для доступа к видеопамяти или области ПЗУ), учитывая атрибут комбинирования. Физически это означает, что сегмент при загрузке в память будет расположен, начиная с этого абсолютного адреса параграфа, но для доступа к нему в соответствующий сегментный регистр должно быть загружено заданное в атрибуте значение. Все метки и адреса в определенном таким образом сегменте отсчитываются относительно заданного абсолютного адреса;
    • STACK — определение сегмента стека. Заставляет компоновщик соединить все одноименные сегменты и вычислять адреса в этих сегментах относительно регистра ss. Комбинированный тип STACK (стек) аналогичен комбинированному типу PUBLIC, за исключением того, что регистр ss является стандартным сегментным регистром для сегментов стека. Регистр sp устанавливается на конец объединенного сегмента стека. Если не указано ни одного сегмента стека, компоновщик выдаст предупреждение, что стековый сегмент не найден. Если сегмент стека создан, а комбинированный тип STACK не используется, программист должен явно загрузить в регистр ss адрес сегмента (подобно тому, как это делается для регистра ds), а также установить регистр SP в правильное значение.
    • По умолчанию атрибут комбинирования принимает значение PRIVATE.


  • Атрибут класса сегмента (тип класса) — это заключенная в кавычки строка, помогающая компоновщику определить соответствующий порядок следования сегментов при собирании программы из сегментов нескольких модулей. Компоновщик объединяет вместе в памяти все сегменты с одним и тем же именем класса (имя класса, в общем случае, может быть любым, но лучше, если оно будет отражать функциональное назначение сегмента). Типичным примером использования имени класса является объединение в группу всех сегментов кода программы (обычно для этого используется класс 'code'). С помощью механизма типизации класса можно группировать также сегменты инициализированных и не инициализированных данных.

  • Атрибут размера сегмента. Для процессоров i80386 и выше сегменты могут быть 16 или 32-разрядными. Это влияет, прежде всего, на размер сегмента и порядок формирования физического адреса внутри него. Атрибут может принимать следующие значения:
    • USE16 — это означает, что сегмент допускает 16-разрядную адресацию. При формировании физического адреса может использоваться только 16-разрядное смещение. Соответственно, такой сегмент может содержать до 64 Кбайт кода или данных;
    • USE32 — сегмент будет 32-разрядным. При формирования физического адреса может использоваться 32-разрядное смещение. Поэтому такой сегмент может содержать до 4 Гбайт кода или данных.
Директива ENDS обозначает конец сегмента. Обе директивы SEGMENT и ENDS должны иметь одинаковые имена.

Упрощенные Директивы Сегментации

Стандартные директивы сегментации изначально использовались для оформления программы в трансляторах MASM и TASM. Поэтому их называют стандартными директивами сегментации. Для простых программ, содержащих по одному сегменту для кода, данных и стека, хотелось бы упростить ее описание. Для этого в трансляторы MASM и TASM ввели возможность использования упрощенных директив сегментации. Но здесь возникла проблема, связанная с тем, что необходимо было как-то компенсировать невозможность напрямую управлять размещением и комбинированием сегментов. Для этого совместно с упрощенными директивами сегментации стали использовать директиву указания модели памяти MODEL, которая частично стала управлять размещением сегментов и выполнять функции директивы ASSUME (поэтому при использовании упрощенных директив сегментации директиву ASSUME можно не использовать). Директива MODEL связывает сегменты, которые в случае использования упрощенных директив сегментации имеют предопределенные имена, с сегментными регистрами (хотя явно инициализировать ds все равно придется).
Пример программы с использованием упрощенных директив сегментации:

;----------------------------------------
masm ;режим работы TASM: ideal или masm
model small ;модель памяти
.data ;сегмент данных
message db 'Введите две шестнадцатеричные цифры,$'
.stack ;сегмент стека
db 256 dup ('?') ;сегмент стека
.code ;сегмент кода
main proc ;начало процедуры main
mov ax,@data ;заносим адрес сегмента
;данных в регистр ax
mov ds,ax ;ax в ds
;далее текст программы (см. сегмента кода в листинге 3.1 книги)
mov ax,4c00h ;пересылка 4c00h в регистр ax
int 21h ;вызов прерывания с номером 21h
main endp ;конец процедуры main
end main ;конец программы с точкой входа main

Синтаксис директивы MODEL:


Модификатор модели памяти

Значение модификатора Назначение
use16 Сегменты выбранной модели используются как 16-битные (если соответствующей директивой указан процессор i80386 или i80486)
use32 Сегменты выбранной модели используются как 32-битные (если соответствующей директивой указан процессор i80386 или i80486)
dos Программа будет работать в MS-DOS

Модель памяти является обязательным параметром директивы MODEL. Этот параметр определяет модель сегментации памяти для программного модуля.

Модели памяти
Модель Тип кода Тип данных Назначение модели
TINY near near Код, данные и стек объединены в одну группу с именем DGROUP и размером до 64Кб. Используется для создания программ формата .com. Некоторые языки эту модель не поддерживают.
СS=DS=SS=DGROUP
SMALL near near Код занимает один сегмент, данные и стек объединены в одну группу с именем DGROUP (хотя для описания могут использоваться разные сегменты). Эту модель обычно используют для большинства программ на ассемблере.
CS=_text
DS=SS=DGROUP
MEDIUM far near Код занимает несколько сегментов, по одному на каждый объединяемый программный модуль. Все ссылки на передачу управления — типа far (вызов подпрограмм). Данные и стек объединены в одной группе DGROUP; все ссылки на них — типа near (для доступа к данным испльзуется только смещение).
CS=<модуль>_text
DS=SS=DGROUP
COMPACT near far Код находится в одном сегменте, данные и стек в группе DGROUP и могут занимать несколько сегментов, так что для обращения к данным требуется указывать сегмент и смещение (
ссылка на данные — типа far).
CS=_text
DS=SS=DGROUP
LARGE far far Код может занимать несколько сегментов, по одному на каждый объединяемый программный модуль. Стек и данные находятся в группе DGROUP. Для ссылки на данные используются дальние указатели -far.
CS=<модуль>_text
DS=SS=DGROUP
HUGE far far Тоже что и модель LARGE, что касается TurboAssebmler.
FLAT far far Тоже, что и TINY, но используются 32-битная адресация, так что максимальный размер сегмента, содержащего и данные, и код, и стек - 4Гб.

Предполагается, что программный модуль может иметь только определенные типы сегментов, которые определяются упомянутыми нами ранее упрощенными директивами описания сегментов. Эти директивы приведены в таблице ниже.

Упрощенные директивы определения сегмента
Формат директивы
(режим MASM)
Формат директивы
(режим IDEAL)
Назначение
.CODE [имя] CODESEG[имя] Начало или продолжение сегмента кода
.DATA DATASEG Начало или продолжение сегмента инициализированных данных. Также используется для определения данных типа near
.CONST CONST Начало или продолжение сегмента постоянных данных (констант) модуля
.DATA? UDATASEG Начало или продолжение сегмента неинициализированных данных. Также используется для определения данных типа near
.STACK [размер] STACK [размер] Начало или продолжение сегмента стека модуля. Параметр [размер] задает размер стека
.FARDATA [имя] FARDATA [имя] Начало или продолжение сегмента инициализированных данных типа far
.FARDATA? [имя] UFARDATA [имя] Начало или продолжение сегмента неинициализированных данных типа far

Наличие в некоторых директивах параметра [имя] говорит о том, что возможно определение нескольких сегментов этого типа. С другой стороны, наличие нескольких видов сегментов данных обусловлено требованием обеспечить совместимость с некоторыми компиляторами языков высокого уровня, которые создают разные сегменты данных для инициализированных и неинициализированных данных, а также констант.

При использовании директивы MODEL транслятор делает доступными несколько идентификаторов, к которым можно обращаться во время работы программы, с тем, чтобы получить информацию о тех или иных характеристиках данной модели памяти.

Идентификаторы, создаваемые директивой MODEL
Имя идентификатора Значение переменной
@code Физический адрес сегмента кода
@data Физический адрес сегмента данных типа near
@fardata Физический адрес сегмента данных типа far
@fardata? Физический адрес сегмента неинициализированных данных типа far
@curseg Физический адрес сегмента неинициализированных данных типа far
@stack Физический адрес сегмента стека

Если вы посмотрите на текст примера, то увидите пример использования одного из этих идентификаторов. Это @data – с его помощью мы получили значение физического адреса сегмента данных нашей программы.

Необязательные параметры язык и модификатор языка определяют некоторые особенности вызова процедур. Необходимость в использовании этих параметров появляется при написании и связывании программ на различных языках программирования.

Язык — необязательный операнд, принимающий значения C, PASCAL, BASIC, FORTRAN, SYSCALL и STDCALL. Если он указан, подразумевается, что процедуры рассчитаны на вызов из программ на соответствующем языке высокого уровня, следовательно, если указан язык C, все имена ассемблерных процедур, объявленных как PUBLIC, будут изменены так, чтобы начинаться с символа подчеркивания, как это принято в C.
Модификатор — необязательный операнд, принимающий значения NEARSTACK (по умолчанию) или FARSTACK. Во втором случае сегмент стека не будет объединяться в одну группу с сегментами данных.
После того как модель памяти установлена, вступают в силу упрощенные директивы определения сегментов, объединяющие действия директив SEGMENT и ASSUME. Кроме того, сегменты, объявленные упрощенными директивами, не требуется закрывать директивой ENDS — они закрываются автоматически, как только ассемблер обнаруживает новую директиву определения сегмента или конец программы.

Директива .CODE описывает основной сегмент кода

.code имя_сегмента

эквивалентно:

_TEXT segment word public ’CODE’

для моделей TINY, SMALL и COMPACT

name_TEXT segment word public ’CODE’

для моделей MEDIUM, HUGE и LARGE (name — имя модуля, в котором описан данный сегмент). В этих моделях директива .CODE также допускает необязательный операнд — имя определяемого сегмента, но все сегменты кода, описанные так в одном и том же модуле, объединяются в один сегмент с именем NAME_TEXT.

Директива .STACK описывает сегмент стека

.stack размер

эквивалентно:

STACK segment para public ’stack’

Необязательный параметр указывает размер стека. По умолчанию он равен 1 Кб.

Директива .DATA описывает обычный сегмент данных

.data

эквивалентно:

_DATA segment word public ’DATA’

Директива .DATA? описывает сегмент неинициализированных данных

.data?

Эквивалентно:

_BSS segment word public ’BSS’

Этот сегмент обычно не включается в программу, а располагается за концом памяти, так что все описанные в нем переменные на момент загрузки программы имеют неопределенные значения.

Директива .CONST описывает сегмент неизменяемых данных

.const

Эквивалентно:

CONST segment word public ’CONST’

В некоторых операционных системах этот сегмент будет загружен так, что попытка записи в него может привести к ошибке.

Директива .FARDATA описывает сегмент дальних данных

.fardata имя_сегмента

эквивалентно:

имя_сегмента segment para private ’FAR_DATA’

Доступ к данным, описанным в этом сегменте, потребует загрузки сегментного регистра. Если не указан операнд, в качестве имени сегмента используется FAR_DATA.

Директива .FARDATA? описывает сегмент дальних неинициализированных данных

.fardata? имя_сегмента

эквивалентно:

имя_сегмента segment para private ’FAR_BSS’

Как и в случае с FARDATA, доступ к данным из этого сегмента потребует загрузки сегментного регистра. Если имя сегмента не указано, используется FAR_BSS.

Во всех моделях памяти сегменты, представленные директивами .DATA, .DATA?, .CONST, .FARDATA и .FARDATA?, а также сегмент, описанный директивой .STACK, если не был указан модификатор FARSTACK, и сегмент .CODE в модели TINY автоматически объединяются в группу с именем FLAT — для модели памяти FLAT или DGROUP — для всех остальных моделей. При этом сегментный регистр DS (и SS, если не было FARSTACK, и CS в модели TINY) настраивается на всю эту группу, как если бы была выполнена команда ASSUME.

Порядок загрузки сегментов

При использовании стандартных директив сегментации сегменты загружаются в память в том порядке, в котором они описываются в тексте программы.

При использовании упрощенных директив сегментации (по умолчанию) устанавливается порядок загрузки сегментов, существующий в MS DOS и часто требуемый для взаимодействия программ на ассемблере с программами на языках высокого уровня.

Порядок загрузки сегментов:

1. Все сегменты класса 'CODE'.
2. Все сегменты, не принадлежащие группе DGROUP и классу 'CODE'.
3. Группа сегментов DGROUP:
3.1. Все сегменты класса 'BEGDATA'.
3.2. Все сегменты, кроме классов 'BEGDATA', 'BSS' и 'STACK'.
3.3. Все сегменты класса 'BSS'.
3.4. Все сегменты класса 'STACK'.

Знание порядка загрузки сегментов необходимо, например, для вычисления длины программы или адреса ее конца. Для этого надо знать, какой сегмент будет загружен последним, и смещение последнего байта в нем.

P.S. В книге Зубкова, порядок загрузки сегментов описан несколько иначе, НО практика показала, что его описание не правильное. При использовании упрощенных директив сегментации, директива .seq, которая, по идее должна устанавливать порядок загрузки сегментов, как они описаны в прорамме, этого не делает! А делает это дериктива .alpha, и то, только при использовании TASM, только в модели small, и при этом она добавляет заголовок в exe файл длиной 600h байт! MASM же, при использовании упрощенных директив сегментации всегда размещает сегменты в соответствии с порядком MS DOS, забивая на директивы .seq и .alpha. И еще с выравниванием сегментов, при использовании упрощенных директив сегментации, происходит какая-то свистопляска :). Все это выявлено опытным путем. Все в следующих сериях супер сериала "Hello World". И так, жем вас у экранов мониторов :)

воскресенье, 17 мая 2009 г.

Синтаксис ассемблера. Метки

Метки
Метка в языке ассемблера может содержать следующие символы:

Буквы: от A до Z и от a до z
Цифры: от 0 до 9
Спецсимволы: знак вопроса (?)
точка (.) (только первый символ)
знак "коммерческое эт" (@)
подчеркивание (_)
доллар ($)

Первым символом в метке должна быть буква или спецсимвол. Цифра не может быть первым символом метки, а символы $ и ? иногда имеют специальные значения и обычно не рекомендуются к использованию. Большие и маленькие буквы по умолчанию не различаются, но различие можно включить, задав ту или иную опцию в командной строке ассемблера. Максимальная длина метки - 31 символ. Примеры меток: COUNT, PAGE25, $E10. Рекомендуется использовать описательные и смысловые метки. Имена регистров, например, AX, DI или AL являются зарезервированными и используются только для указания соответствующих регистров.
Если метка располагается перед командой процессора, сразу после нее всегда ставится символ «:» (двоеточие), который указывает ассемблеру, что надо создать переменную с этим именем, содержащую адрес текущей команды:
some_loop:
lodsw ; cчитать слово из строки,
cmp ax,7 ; если это 7 - выйти из цикла
loopne some_loop

Когда метка стоит перед директивой ассемблера, она обычно оказывается одним из операндов этой директивы и двоеточие не ставится:

codesg segment
lodsw ; cчитать слово из строки,
cmp ax,7 ; если это 7 - выйти из цикла
codesg ends

Рассмотрим директивы, работающие напрямую с метками и их значениями: LABEL, EQU и =.

Директива LABEL

метка   label      тип
Директива LABEL определяет метку и задает ее тип. Тип может быть одним из: BYTE (байт), WORD (слово), DWORD (двойное слово), FWORD (6 байт), QWORD (учетверенное слово), TBYTE (10 байт), NEAR (ближняя метка), FAR (дальняя метка). Метка получает значение, равное адресу следующей команды или следующих данных, и тип, указанный явно. В зависимости от типа команда
mov      метка,0
запишет в память байт (слово, двойное слово и т.д.), заполненный нулями, а команда
call     метка
выполнит ближний или дальний вызов подпрограммы.

С помощью директивы LABEL удобно организовывать доступ к одним и тем же данным, как к байтам, так и к словам, определив перед данными две метки с разными типами.


Директива EQU

Директива EQU присваивает метке значение, которое определяется как результат целочисленного выражения в правой части. Результатом этого выражения может быть целое число, адрес или любая строка символов:
метка   equ      выражение

truth equ 1
message1 equ 'Try again$'
var2 equ 4[si]
cmp ax,truth ; cmp ax,1
db message1 ; db 'Try again$'
mov ax,var2 ; mov ax, 4[si]
Директива EQU чаще всего используется с целью введения параметров, общих для всей программы, аналогично команде #define препроцессора языка С.

Директива =

Директива = эквивалентна EQU, но определяемая ею метка может принимать только целочисленные значения. Кроме того, метка, указанная этой директивой, может быть переопределена.

Каждый ассемблер предлагает целый набор специальных предопределенных меток — это может быть текущая дата (@date или ??date), тип процессора (@cpu) или имя того или иного сегмента программы, но единственная предопределенная метка, поддерживаемая всеми рассматриваемыми нами ассемблерами, — $. Она всегда соответствует текущему адресу. Например, команда

jmp $

выполняет безусловный переход на саму себя, так что создается вечный цикл из одной команды.

Чтобы получше уяснить все это дело я написал небольшую программку. Все тот же “Hello World”, но на новый лад :) Текст ниже:


Програ ассемблируется TASM и MASM, но EXE файлик, ассемблированный MASM на один байт больше. Замечаем что команду mov dx,offset msg, заменили на команду lea dx,msgb. LEA помещает адрес смещения указанных данных в DX, т.е. делает то же самое что и команда mov с offset. Рекомендую это посмотреть под отладчиком.


Смотрим внимательно листинги ассемблирования и находим разницу.


Интересно, что TASM ассемблировал команду LEA в данном случае как команду MOV (код операции BA), а MASM ассемблировал команду LEA в другой код операции - 8D16, что и увеличило размер программы на 1 байт. Почему он решил так сделать пока не знаю, но интересно было бы выяснить.

суббота, 16 мая 2009 г.

Вспоминаем первый шаг

Первым нашим шагом был вывод даты ROM BIOS в debug.exe. Теперь создадим программку, которая будет это делать сама. В книге «Язык ассемблера: уроки программирования» на стр. 32 есть эта программа, но в ней есть ошибки. Ошибки я исправил. Вот рабочий вариант этой программы:

Во всех многочисленных инкарнациях программы hello.asm для вывода на экран использовалась функция DOS 09h. Однако она требует, чтобы в конце выводимой строки стоял знак $. В ROM BIOS такого знака, естественно, нет. Поэтому для ввода на экран придется воспользоваться другой функцией DOS – 40h. Она позволяет задавать число выводимых байтов в регистре CX. Это универсальная функция, с помощью которой можно вывести на любое устройство (экран, принтер, файл и последовательный порт). Приемное устройство характеризуется значением дескриптора, которое записывается в регистр BX. Для экрана предусмотрен предопределенный дескриптор 1.
Эта программа, еще своеобразна тем, что в ней отсутствует сегмент данных. Это вполне допустимо.
В первых предложениях программы, выполняется инициализация сегментного регистра DS, однако он настраивается не на сегмент данных, а на сегмент памяти, в котором можно найти дату ROM BIOS. Далее настраиваются регистры BX, CX и DX, с помощью которых DOS передаются параметры для правильного выполнения функции вывода.
Прога ассемблируется и MASM и TASM. Ради спортивного интереса решил их сравнить побайтово с помощью fc(file compare) – стандартной проге винды. Делается это так (относительно моих каталогов конечно):

Самая первая (самая левая) колонка отображает смещение, вторая байты по этому смещению в файле ассемблированному TASM, третья – в файле MASM.
Как видно различаются только несколько первых байта в заголовке файлов. Размер файлов одинаковый, код самой программы, как видно совпадает байт в байт. Почему немного различаются заголовки, это я пока не знаю. Видимо сказываются различия ассемблеров.
Ну и напоследок запустим саму прогу и посмотрим ее вывод.

В принципе, в этой программе нет необходимости и в стеке. Так что его определение можно убрать. Программа ассемблируется и TASM и MASM, но оба выдают предупреждение, что нет стека. В нашей проге на это можно забить.

пятница, 15 мая 2009 г.

Игры с Turbo Debagger

После знакомства немного поиграем с отладчиком, чтобы получше его узнать.
В отладчике можно менять и значения регистров по ходу выполнения программы. Сделаем следующий финт ушами – загрузим программу hello4.exe снова в отладчик и выполним все команды до первой команды int 21h. К этому моменту в регистр DX будет помещено смещение поля данных msg, в данном случае 0000. Изменим значение регистра DX на 5. Теперь выполним команду int 21h и DOS выведет на экран строку, начало которой расположено на 5 байте сегмента данных (помним нумерация начинается с нуля). В нашем случае смещение 5 указывает на буку е. То есть будет выведена фраза ' ello World *=-'. Медитируем, просветляемся :)

Еще одной полезной опцией отладчика является вывод содержимого области памяти, начиная с заданного адреса (дамп памяти). Таким образом можно увидеть содержимое не только поля данных программы, но и содержимое вообще любых участков памяти компьютера, в частности системных таблиц. Посмотрим, например, как выглядит в памяти блок окружения программы.
Любая программа, загруженная в память состоит из двух отдельных блоков: собственно программы и ее окружения, которое располагается обычно перед программой, хотя не обязательно вплотную к ней.
Окружение представляет собой область памяти, в которой в виде символьных строк записаны значения переменных, называемых переменными окружения, например: path, set и т.д.
Сегментный адрес окружения загружаемой программы записывается ОС в PSP со смещением 2Ch от его начала. Чтобы увидеть все это дело, снова загружаем hello4.exe в отладчик открываем окно CPU, переходим в окно дампа памяти и даем команду Goto и параметр ей 2C, жамкаем Enter и видим:

Внимательно медитируем на цифири 0A 15…. Что это? А это сегментный адрес окружения программы, только наоборот :), то есть 150A. Еще раз жмем Goto, параметр 150A:0 и видим:

К сожалению в окне CPU нельзя изменять взаимный размер окон и окно дампа памяти всегда оказывается не большим. Если хотим увидеть сравнительно большой участок памяти, лучше это сделать выбрав пункт меню View->Dump. И там проделать все те же операции, что мы выполнили до этого.

четверг, 14 мая 2009 г.

Hello Turbo Debugger :)

Теперь будем знакомится с Turbo Debagger -ОМмммм..... :)
Чтобы знакомство нашей супер программы hello.asm прошло с отладчиком хорошо, ее надо подготовить к знакомству :)
Делается это следующим образом – при ассемблировании надо добавить ключик /zi, который добавит в объектный файл отладочную информацию. Скопируем hello.asm в hello4.asm и ассемблируем следующим образом: tasm /la /zi hello4. И затем линкуем следующим образом: tlink /v hello4. Ключик /v включает в исполняемый файл информацию для отладчика.

Теперь загружаем нашу программу в Trubo Debugger командой td hello4 (перед этим следует убедится, что файл с текстом программы hello4.asm и исполняемый файл hello4.exe находятся в одной папке, так как отладчик при своей работе использует оба этих файла).
Запускаем нашу прогу под отладчиком: td hello4 и видим кадр отладчика, в котором видны два окна - окно Module с исходным текстом отлаживаемой программы и окно Watches для наблюдения за ходом изменения заданных переменных в процессе выполнения программы. Окно Watches нам пока не понадобится, и его можно убрать, щелкнув мышью по маленькому квадратику в левом верхнем углу окна, или введя команду [ALT]+[F3], предварительно сделав это окно активным. Переключение (по кругу) между окнами осуществляется клавишей [F6].

Следует заметить, что если вы писали программу в кодировке Windows (CP-1251), то вместо комментариев на русском языке увидите всякую абракадабру. Если это произошло, то можете воспользоваться плагином FarTrans для FAR manger чтобы изменить кодировку файла.
В процессе отладки программы на экран приходится выводить много дополнительных окон; они перекрываются и часто скрывают друг друга. Чтобы увидеть их все одновременно, размер окон приходится уменьшать, а сами окна перемещать по экрану. Режим изменения размеров и положения окна включается командой [Ctrl]+[F5], после чего клавиши со стрелками перемещают окно по экрану, а те же клавиши при нажатой клавише [Shift] позволяют изменять его размер. Выход из режима настройки окна осуществляется нажатием клавиши [Enter].
Начальное окно отладчика дает слишком мало информации для отладки программы. В нем можно выполнять программу по частям до местоположения курсора (клавиша [F4]) и команда за командой (клавиша [F8]); можно также с помощью окна Watches наблюдать изменения заданных полей данных. Однако для отладки программы на уровне языка ассемблера необходимо контролировать все регистры процессора, включая регистр флагов, а также, во многих случаях, поля данных вне программы (например, векторы прерываний или системные таблицы). Гораздо более информативным является "окно процессора", которое вызывается с помощью пункта Vicw>CPU верхнего меню или командой [Alt]+[V] [C].
Кроме того в стандартном размере окна помещается не слишком много информации, поэтому его лучше увеличить, выбрав Options->Display options… и далее выбрать Screen lines 43/50, а для корректного отображения табуляции установить Tab size равным 8.
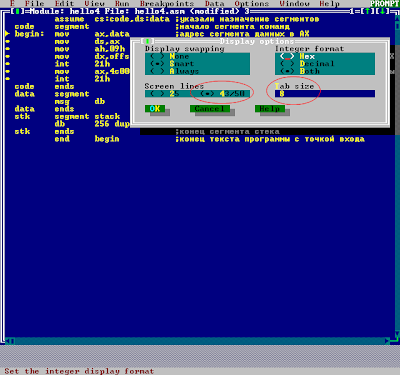
Теперь открываем окно CPU (View->CPU) , видим следующее:

Медитируем и просветляемся...
Окно процессора состоит, в свою очередь, из 5 внутренних окон для наблюдения текста программы на языке ассемблера и в машинных кодах, регистров процессора, флагов, стека и содержимого памяти. С помощью этих окон можно полностью контролировать ход выполнения отлаживаемой программы. Для того чтобы можно было работать с конкретным окном, например, прокручивать его содержимое, надо сделать его активным, щелкнув по нему мышью. Перейти из окна в окно можно также с помощью клавиатуры, нажимая клавишу Tab. Посмотрим, какие сведения можно извлечь из содержимого окна процессора.
Содержимое сегментных регистров DS и ES одинаково и составляет 1547h. Как мы помним они указывают на начало PSP. Длина PSP составляет 256 байт или 100h байт или 10h параграфов. Прибавляем 10h к 1547h получаем 1557h, то есть начало сегмента кодов, что и подтверждается содержимым регистра CS. Регистр SS в результате инициализации ОС получил значение 155B. Начало стека отстоит от начала сегмента кода на 4 параграфа – 2 параграфа занимает сегмент кода (с учетом «пустых» байт) и 2 параграфа занимают данные (так же с учетом «пустых» байт). Итак CS=1557h прибавляем к нему 4 параграфа и получаем 155Bh. Как помним SP у нас содержит величину равную размеру стека, которую мы определили в программе, то есть 100h байт (256 байт десятичное) и указывает на «дно» стека. Регистр IP имеет смещение 0000 и указывает на первую исполняемую команду нашей программы (вспоминаем то, что уже знаем про точку входа в программу). В окне дампа памяти, мы естественным образом не видим наших данных, так как регистр DS еще не был инициализирован в нашей программе соответствующим значением. Это делают, как мы помним, первые две команды нашей программы. А они еще не выполнены. Скриншот сделан еще до выполнения первой команды.
Первая команда у нас имеет вид в машинном коде B85915, что соответствует команде mov ax,data. То есть в AX заносится сегментный адрес начала сегмента данных, который равен, в данном случае 1559h (не забываем, что байтики идут в обратном порядке). Давайте разберемся почему именно такое число. Сегмент данных у нас в программе определен сразу за сегментом кода. Сегмент кода у нас начинается с адреса 1557h (CS=1557h) и занимает 2 параграфа, далее за ним начинается сегмент данных. 1557h + 2h = 1559h, что мы и видим в отладчике.
Теперь попробуем разобраться с остальными значениями регистров. Содержимое всех регистров общего назначения (АХ, ВХ, СХ, DX, SI, DI и ВР) равно 0. Отсюда можно сделать вывод, что DOS, загружая программу в память, очищает регистры процессора. Однако на самом деле это совсем не так! Регистры очищает не DOS, а отладчик. При обычном запуске программы исходное содержимое регистров практически непредсказуемо, и ни в коем случае нельзя рассчитывать, что в них будут нули. Иногда можно столкнуться и с более тонким влиянием отладчика на ход выполнения программы, вплоть до того, что некоторые виды программ, например, управляющие подключенной к компьютеру аппаратурой, в отладчике будут выполняться просто неверно.
Так же мы видим в стеке по смещению 100h значение 52FB и по смещению 00FE значение 0000. Но мы же ни чего в стек не вносили! Мы то да, а вот отладчик внес эти значения для своих нужд. Еще один пример "самодеятельности" отладчика можно увидеть в окне исходного текста. Там есть странные команды add [bx+si],al. Таких команд, да еще в таком количестве, в нашей программе нет, их "придумал" отладчик, пытаясь дизассемблировать промежуток между сегментом команд и сегментом данных и сегментом данных и стеком, которые заполненны нулями. Код 0000h соответствует команде add [bx+si],al, которую и изобразил отладчик. То же самое можно сказать по поводу команд sub ch,[bp+si] – это попытка отладчика представить содержимое стека в дизассемблированном виде.
ыполним две первые команды программы, дважды нажав клавишу [F8]. Состояние программы после этой операции показано ниже:

Видно, что указатель команд получил значение 5 и показывает на очередную (еще не выполнявшуюся) команду mov AH,09h, относительный адрес которой равен 5. Сегментный регистр DS получил значение 1559h, что должно соответствовать сегментному адресу сегмента данных. Вспомним, что сегмент команд у нас занимает 11h байт и требует в памяти 2 параграфа (с учетом «пустых» байт выравнивания на границу параграфа). Сегмент команд имеет сегментный адрес 1557h, следовательно, сегментный адрес сегмента данных должен быть равен 1559h, что мы и получили.
Те регистры или флаги, которые изменили свое значение, отладчик подсвечивает белым цветом. Кроме того, следует заметить, что в отличие от отладчика debug.exe дамп памяти выводится не по целому параграфу (16 байт), а по половине параграфа (8 байт).
Итак, после выполнения двух первых команд в окне дампа памяти мы опять не увидели своих данных, так как там отобразилось содержимое памяти относительно значения в регистре ES.
Для того, чтобы вывести на экран что-либо иное, надо воспользоваться командой [Alt]+[F10], которая для каждого внутреннего окна процессора открывает дополнительное меню. Вид этого меню зависит от того, какое окне было активным в момент ввода команды.
Чаще всего приходится пользоваться первым пунктом этого меню Goto, с помощью которого можно задать любой адрес (входящий или не входящий в сегменты программы), и получить дамп этого участка. На скриншоте видно содержимое окна дампа после ввода начального адреса в виде DS:0 (тот же результат даст начальный адрес DS:msg, а так же и просто msg, так как по умолчанию сегментный адрес берется из DS). Как и следовало ожидать, по этому адресу расположено наше единственное данное - строка текста, выводимая программой на экран. Кстати, в окне дампа видно начало промежутка между сегментами (данных и стека), заполненного нулями.

Важнейшим элементом отладки программы является наблюдение значений тех или иных полей данных, особенно тех, которые заполняются программой динамически, т.е. по ходу ее выполнения. Для того чтобы вывести на экран содержимое поля данных, надо поместить курсор на имя этого поля в синем окне, начального кадра отладчика (например, msg в нашем случае) и выбрать пункт меню Data->Inspect. В появившемся окне ввода переменной можно скорректировать имя интересующего нас поля данных или ввести новое; если имя правильное достаточно нажать клавишу Enter.

В кадр отладчика будет выведено окно с характеристиками и содержимым указанной переменной. Отладчик сообщает, что переменная msg хранится в памяти по адерсу 1559:0000, т.е. имеет сегментный адрес 1559h и смещение 0000h, и описана как последовательность из 20 байт. Тут же приводятся значения всех байт нашей строки, включая их начертание на экране, а также десятичное и шестнадцатеричное представление.
В окне Inspecting можно изменить значение отображаемого поля данных. Для этого надо, сделав это окно активным и поместив курсор на отображение конкретного элемента нашего символьного массива, например элементы с индексом 0 и 18 (знак ‘-‘), ввести команду [Alt]+[F10] для открытия внутреннего меню этого окна и выбрать пункт Change. Выбрав этот пункт, мы получим окно, в котором можно ввести требуемое значение изменяемого данного. В нашем случае это символ '!', которым будет заменен символ '-'. Можно было вместо символа в одинарных кавычках ввести его шестнадцатеричный или десятичный ASCII код, если он известен (в нашем случае 21h или 33d).

Если теперь, не выходя из отладчика, выполнить программу до конца, на экран будет выведена фраза «!=* Hello World *=!», вместо фразы «-=* Hello World *=-». Для того чтобы находясь в отладчике увидеть результат работы программы, надо ввести команду [Alt]+[F5] или выбрать пункт меню Window-> User screen. Возврат в кадр отладчика осуществляется нажатием любой клавиши.
Важно понимать, что любые изменения, вносимые в текст программы в процессе работы с отладчиком, будут действовать только до конца данного сеанса (даже точнее говоря, до рестарта программы). Отладчик изменяет не файл, хранящийся на диске, а только его копию в памяти. Рестарт программы можно сделать нажав клавиши [Ctrl]+[F2] или выбрав пункт меню Run->Program reset.
Пошагово исполнять программу можно при поморщи клавиш F8 или F7. Каждая из них выполняет одно предложение программы, но различие этих команд весьма существенно: команда F7 (trace, трассировка) позволяет войти внутрь вызываемых подпрограмм, а так же выполнять циклы шаг за шагом. Команда F8 (step, шаг), наоборот, выполняет подпрограммы и циклы как одно неразрывное действие, что заметно ускоряет пошаговую отладку программы, при условии, что мы уверены, что вызываемая подпрограмма выполняется правильно.
Можно выполнить сразу целый фрагмент программы, т.е. несколько предложений. Для этого надо поместить курсор _ перед тем предложением, на котором требуется сделать остановку (или на любой символ внутри него), и нажать клавишу F4. Выполнятся все строки программы до той на которой установлен курсор, а значок ► переместится на эту строку.

среда, 13 мая 2009 г.

Точка входа

После всех проделанных упражнений, пришла догадка, что точка входа в программу не обязательно должна находится в начале программы, а может быть, по идее где угодно. Решил сделать небольшой эксперимент. Чуток изменил программу hello.asm следующим образом (дал ей имя hello3.asm :-D ):

Далее транслируем прогу и смотрим в листинг.

Сделанные изменения – это перенос точки входа в программу. Внимательно изучаем текст и листинг. А теперь более подробно о команде безусловного перехода jmp next. Команда совершает безусловный переход на метку, указанную в ее операнде, в данном случае – next. Переход осуществляется на 19d байт назад, то есть на -19d байт. -19d = 11101101b = ED. Что мы и видим в ассемблированном коде листинга – EB ED. EB – это код команды jmp, а ED – смещение на -19 байт.
Замечаем, что точка входа в программу находится по смещению 000C.
Теперь смотрим hello3.exe в hex просмотровщике.

А теперь посмотрим hello3.exe с помощью знаменитой программы HIEW (версия 6.86). HIEW – это и hex редактор, и простой дизассемблер и … много чего еще и.
Загружаем прогу в HIEW жмем Enter два раза, чтобы получить дизассемблированный листинг. Жмем F5 вводим 200 и попадаем в начало сегмента кода, не путать с точкой входа в программу.

Hiew в режиме Decode (дизассемблера), «пустые» промежутки (00) между кодом и данными дизассемблировал как команду [bx][si],al. Сие надо учитывать при использовании дизассемблеров и отладчиков, так как они не знают где код, а где данные. В debug данные тоже можно вывести в виде команд ассемблера при помощи команды u. Ну это все пока так, на заметку.
Жмем F8 в HIEW и видим информацию заголовка программы.

Из заголовка можно видеть точку входа в программу, а так же начальное значение регистра IP. На что и помедитируем в дебагере.

вторник, 12 мая 2009 г.

Здравствуйте, я ваша тётя!

Продолжение сериала с программой hello.asm :)
Сперва медитативная часть. Вспоминаем, что один и тот же физический байт памяти может иметь различные логические адреса, определяемые разными, но при этом эквивалентными парами сегмент-смещение. Скриншот для медитации:

Замечаем, что в выводе команды d cs:0, наши данные располагаются по адресу 144B:0020, а в выводе команды d ds:0, наши данные располагаются по адресу 144D:0000. Дам был сделан после исполнения двух первых команд программы. Медитируем и просветляемся :).
Далее практическая часть.
Справедливости ради, оттранслируем hello.asm при помощи MASM с ключами генерации листинга и карты. Запускаем m.bat и даем команду ml /Fl /Fm hello.asm. Замечаем что для MASM надо указывать расширение – .asm. В результате работы ассемблера получаем четыре файла: hello.obj, hello.lst, hello.map и hello.exe.

Посмотрим содержимое файла hello.lst.

Сгенерированный MASM-ом листинг очень похож на тот, что создал TASM. Есть лишь не большие различия. В листинге MASM отсутствуют номера строк программы. Так же, немного различается, вывод команд по смещениям 0000 и 0007, хотя суть одна и та же.
Теперь начнем эксперименты с выравниваниями сегментов. Изменим немного программу hello.asm добавив атрибут выравнивания byte к командам описаниям сегментов. Cохраним текст программы, как hello1.asm, ассемблируем с генерацией листинга, и посмотрим, что получилось.
Из последнего скриншота видно, что пропали пустые промежутки между сегментом кода и сегментом данных, и сегментом данных и сегментом стека. Значит программа hello1.exe, по идее, должна стать на 27 байт меньше, то есть 805 байт. Так оно и есть.

Если внимательно посмотреть, то немного изменились и заголовки программ. Но с форматом заголовков буду разбираться попозже. Щас играемся с сегментами.
Теперь опять медитация. Будем созерцать под отладчиком обе программы: hello.exe и hello1.exe.
Для вывода дизассемблированного кода программы используется команда – u (unassemble), параметрами которой является диапазон смещений в сегменте. Наша программа имеет размер 11h байт. То есть наши 11h байт располагаются в адресном пространстве с 0h по 10h. Чтобы вывести дизассемблированный листинг этого пространства даем команду u cs:0 10.
Как видно из дампов памяти отладчиков, в программе hello.exe присутствуют пустые промежутки (отмечены зеленым), в программе hello1.exe их нет, так как использовался атрибут выравнивания byte в директивах segment. В результате этого произошло смещение сегмента данных, что отразилось на команде mov dx,offset msg, которая в программе hello.exe имеет вид mov dx,0000, а в программе hello1.exe – mov dx,0001.
Еще один интересный момент это то, что команда mov ax,data в обеих программах имеет одинаковый машинный код mov ax,144D, не смотря на то, что в программе hello1.exe мы применили выравнивание параграфа. К чему бы это? И почему бы это? Вспоминаем, что сегментная часть адреса всегда кратна 16 или 10h. Наша программа занимает больше одного параграфа на 1 байт. Поэтому ассемблер, видя, что сегмент кода занимает больше одного параграфа, но меньше двух, определил сегментную часть адреса сегмента данных на 20h байт (2 параграфа) отстоящую от начала сегмента кода. Соответственно в программе hello.exe сегмент данных начинается на границе параграфа, то есть имеет смещение 0, а в программе hello1.exe, сегмент данных, из-за атрибута выравнивания, имеет смещение в 1 байт (в данном случае), от начала параграфа. Что мы и видим в коде команды mov dx,offset msg.

Теперь поперемещаем сегменты и посмотрим, как это отразится на листинге программы и ее коде. Создадим «новую» программку – hello2.asm. Определим в ней данные перед сегментом кода.

От сюда видно, что сегменты располагаются в том порядке, как они были объявлены в программе. Теперь помедитируем – посмотрим прогу под дебагером :)

Из дебагера видно, что данных не видно :) … ну при текущем расположении сегментов в программе…. Если внимательно смотрели предыдущие дампы, то данные сразу можно было видеть в выводе команды d cs:0. Теперь их не видно, так как данные располагаются выше в адресном пространстве, чем данные. Но все же при помощи хитрого хака, их можно увидеть еще до инициализации сегментного регистра DS сегментным адресом данных. Для этого поменяем значение сегментного регистра ES (так как его наша программа не использует), на сегментный адрес 144C (от куда взялся этот адрес? … это предмет медитации ;) ). И так даем команду r es и жмем Enter, потом вводим 144C и жмем Enter, потом вводим d es:0 и жмем Enter и видим наши данные.

Обратите внимание, что еще ни одна команда программы не выполнена.
Выполняем две первые команды нашей программы и смотрим сегмент данных.

Далее выполняем остальные команды программы и анализируем это :)..... сами....